
国家研究課題分析パイプライン
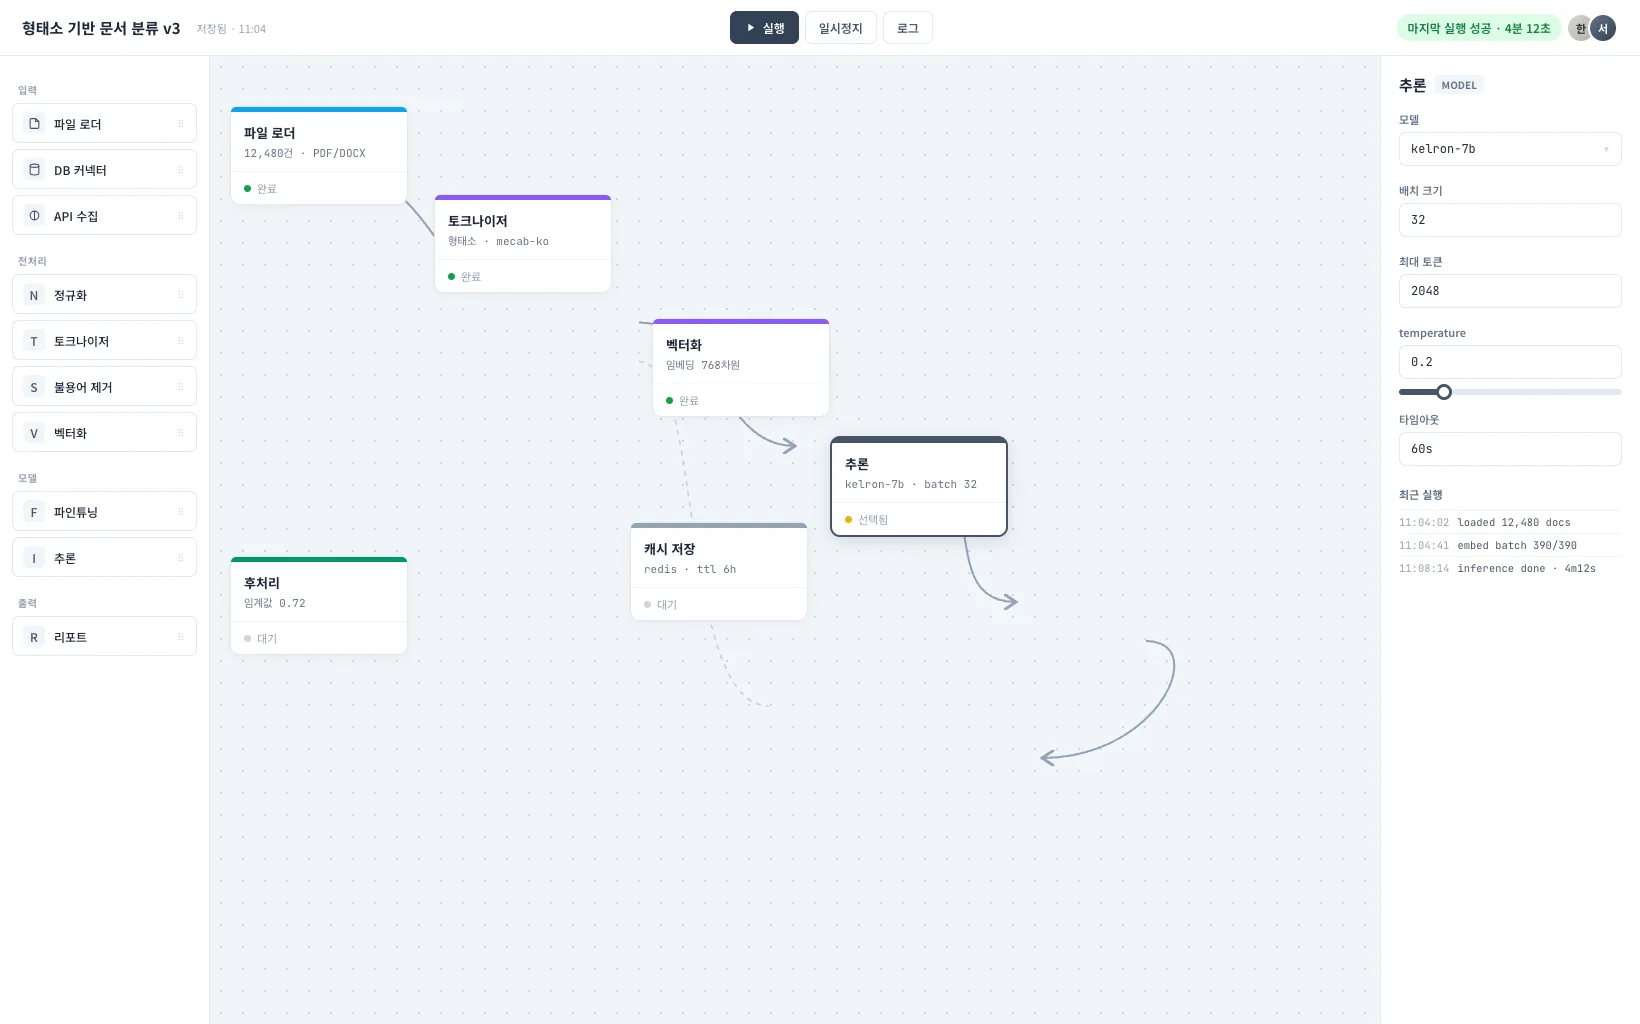
前処理から推論までをノードでつなぎ、研究員自身が構成できるようにしました。
- 開発期間
- 約6か月
- 体制
- 4名
- 対応プラットフォーム
- ウェブ · サーバー
- 構成方式
- ノードベースのパイプライン
背景
研究員が毎回開発チームに依頼しなければ、データ前処理からモデル推論までのパイプラインを変更できませんでした。研究の方向性が頻繁に変わる国家研究課題の特性上、開発チームを介さずに研究員自身が構成を調整できる必要がありました。
実装範囲
- データ前処理ノードの構成
- 推論ノードの接続・実行
- パイプラインの保存・再利用
- 実行結果の照会
- 文書検索ベースの補助ノード
技術選定
その状況で何をなぜ選んだか前処理から推論までをノード単位に分割し、接続方式で構成
研究員ごとに必要な前処理段階やモデルの組み合わせが異なり、固定された一つのパイプラインでは対応できませんでした。各段階を独立したノードとして作り、研究員が必要なノードだけを選んで接続できるようにしたことで、新しい実験構成のたびに開発チームへの依頼なしですぐ試せるようになりました。
文書検索ノードをRAG構造で別途構成
研究過程で参考論文や過去の実験記録を探す必要がある場面が多くありました。これを別の検索ノードとして作り、他の推論ノードと自由に接続できるようにしました。
技術課題
課題
ノードを自由に接続できるようにしたところ、研究員が誤った順序で接続してしまい実行が途中で失敗するケースが多く見られました。
アプローチ
ノードごとに入力・出力のデータ形式を定義し、形式が合わない接続は実行前に画面上であらかじめ表示するようにしました。
結果
実行後に失敗を確認する代わりに、接続の段階で問題をあらかじめ発見できるようになりました。
課題
PyTorchベースの推論ノードが重いモデルを使う際に実行時間が長くなり、同じサーバー上で他の研究員のパイプライン実行が滞ってしまいました。
アプローチ
推論ノードの実行を待ち行列で管理し、実行中のパイプラインの状態を各研究員の画面で確認できるようにしました。
結果
サーバー資源が競合する状況でも、どの実行が先に処理されるのかを研究員が把握できるようになりました。
引き継ぎと運用
研究員向けのノード構成ガイドとパイプラインの保存・再利用方法を文書で提供しました。ソースコードと実行環境の構成を引き渡し、新規ノードタイプの追加は課題の進行に合わせて別途支援しました。