
社内文書アシスタント
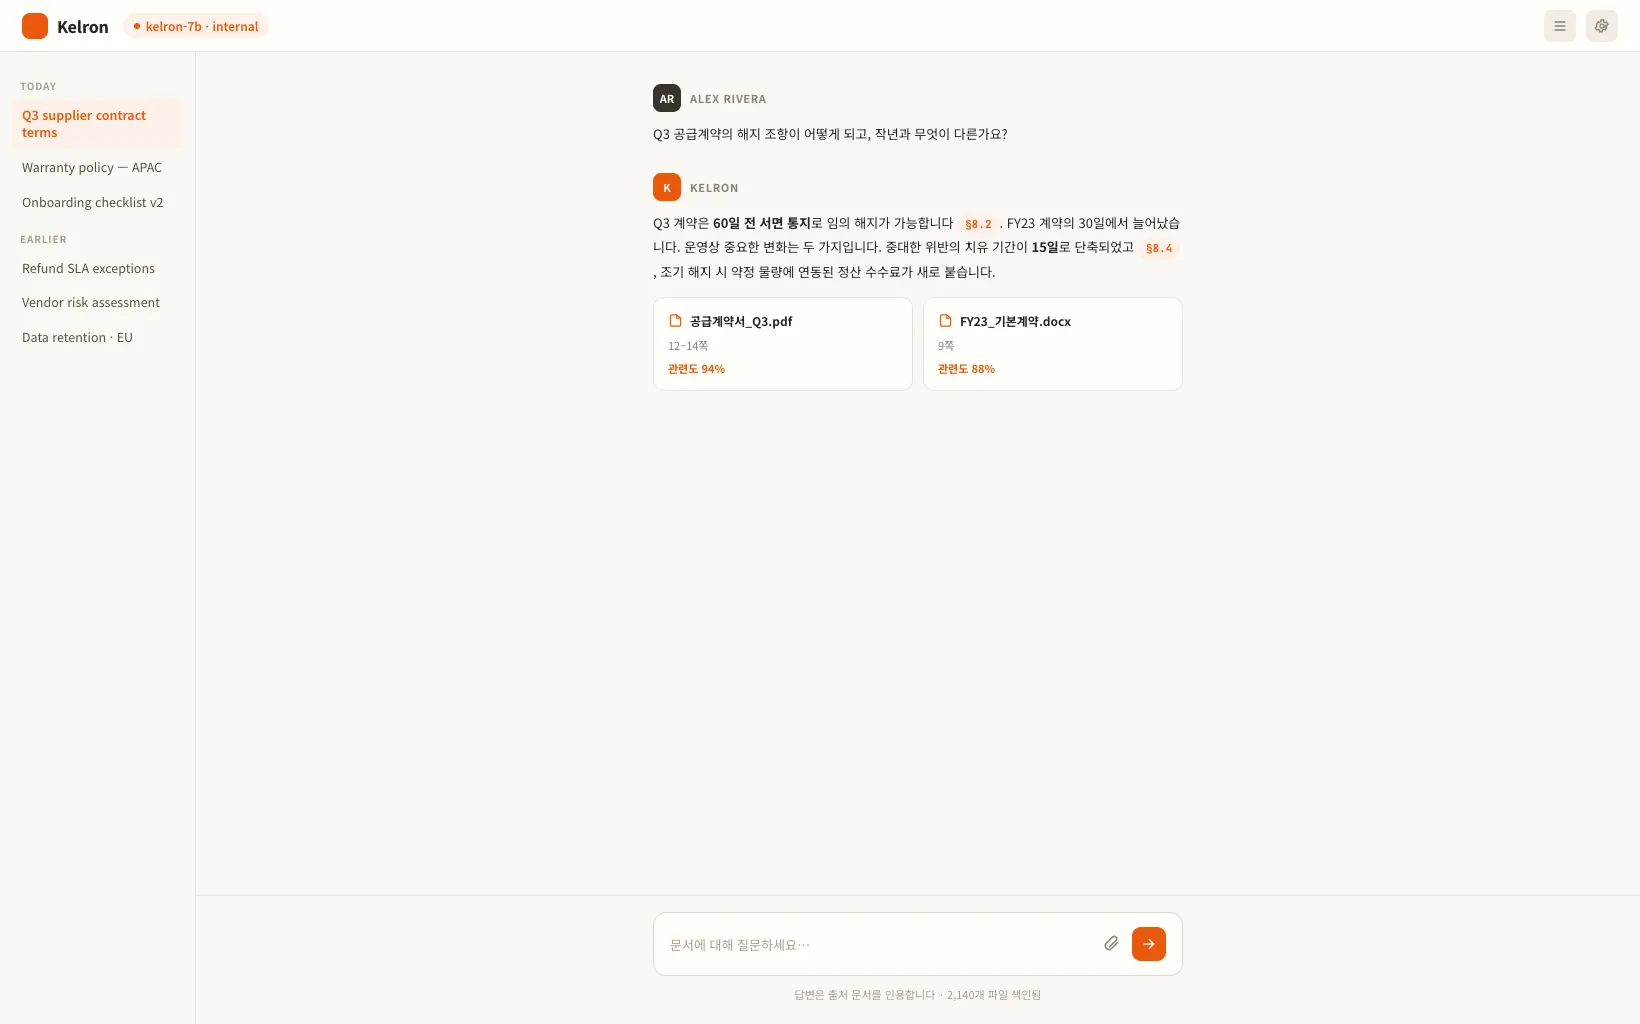
社内文書を根拠に回答し、出典もあわせて示すAIです。
- 開発期間
- 約5か月
- 体制
- 4名
- 対応プラットフォーム
- ウェブ · サーバー
- 導入形態
- 社内網への構築
背景
社内規程や技術文書を検索したいものの、外部のLLMサービスに文書をアップロードできないというセキュリティ方針がありました。文書を社外に出さずに質問へすぐ答えられる仕組みが必要でした。
実装範囲
- 社内文書の索引化・収集
- 自然言語での質疑応答
- 回答の根拠文書の表示
- 文書更新の反映
- 質問履歴の管理
技術選定
その状況で何をなぜ選んだか外部LLMではなく社内網の中で動く言語モデルを構築
文書を外部に持ち出さないことが要件の前提でした。モデルを社内インフラに置くことで、質問と文書が会社の境界を越えない構造を作れました。
RAG構造により回答に根拠文書を併せて提示
モデルが回答を生成するだけでは、その回答が正しいか確認する方法がありません。ベクトルDBから関連文書をまず検索し、その文書を根拠として回答させることで、利用者が回答と同時に原文をすぐ確認できるようにしました。
技術課題
課題
社内文書は継続的に改定されますが、索引が更新されないと、すでに廃止された規程を根拠に回答してしまう問題がありました。
アプローチ
文書改定時にその文書だけをベクトルDBで再索引化するパイプラインを作り、文書のバージョンも併せて記録することで、回答に反映された文書が最新版かどうかを確認できるようにしました。
結果
規程が変わっても次の索引更新の周期内に回答へ反映され、どのバージョンの文書を根拠に答えたかを追跡できるようになりました。
課題
質問があいまいだったり関連文書が複数あったりすると、モデルが根拠のない内容を混ぜて回答することがありました。
アプローチ
検索された文書と回答内容を照合し、根拠文書にない内容が含まれる場合はその旨を回答に表示するようにしました。
結果
根拠が不十分な回答を利用者が見分けられるようになり、確認せずそのまま引用してしまうリスクを減らせました。
引き継ぎと運用
社内管理者に文書登録・再索引化の方法とモデル運用ガイドを提供しました。ソースコードと社内網への配布構成を引き渡し、モデルのチューニングと文書拡張は別途の保守で対応しました。